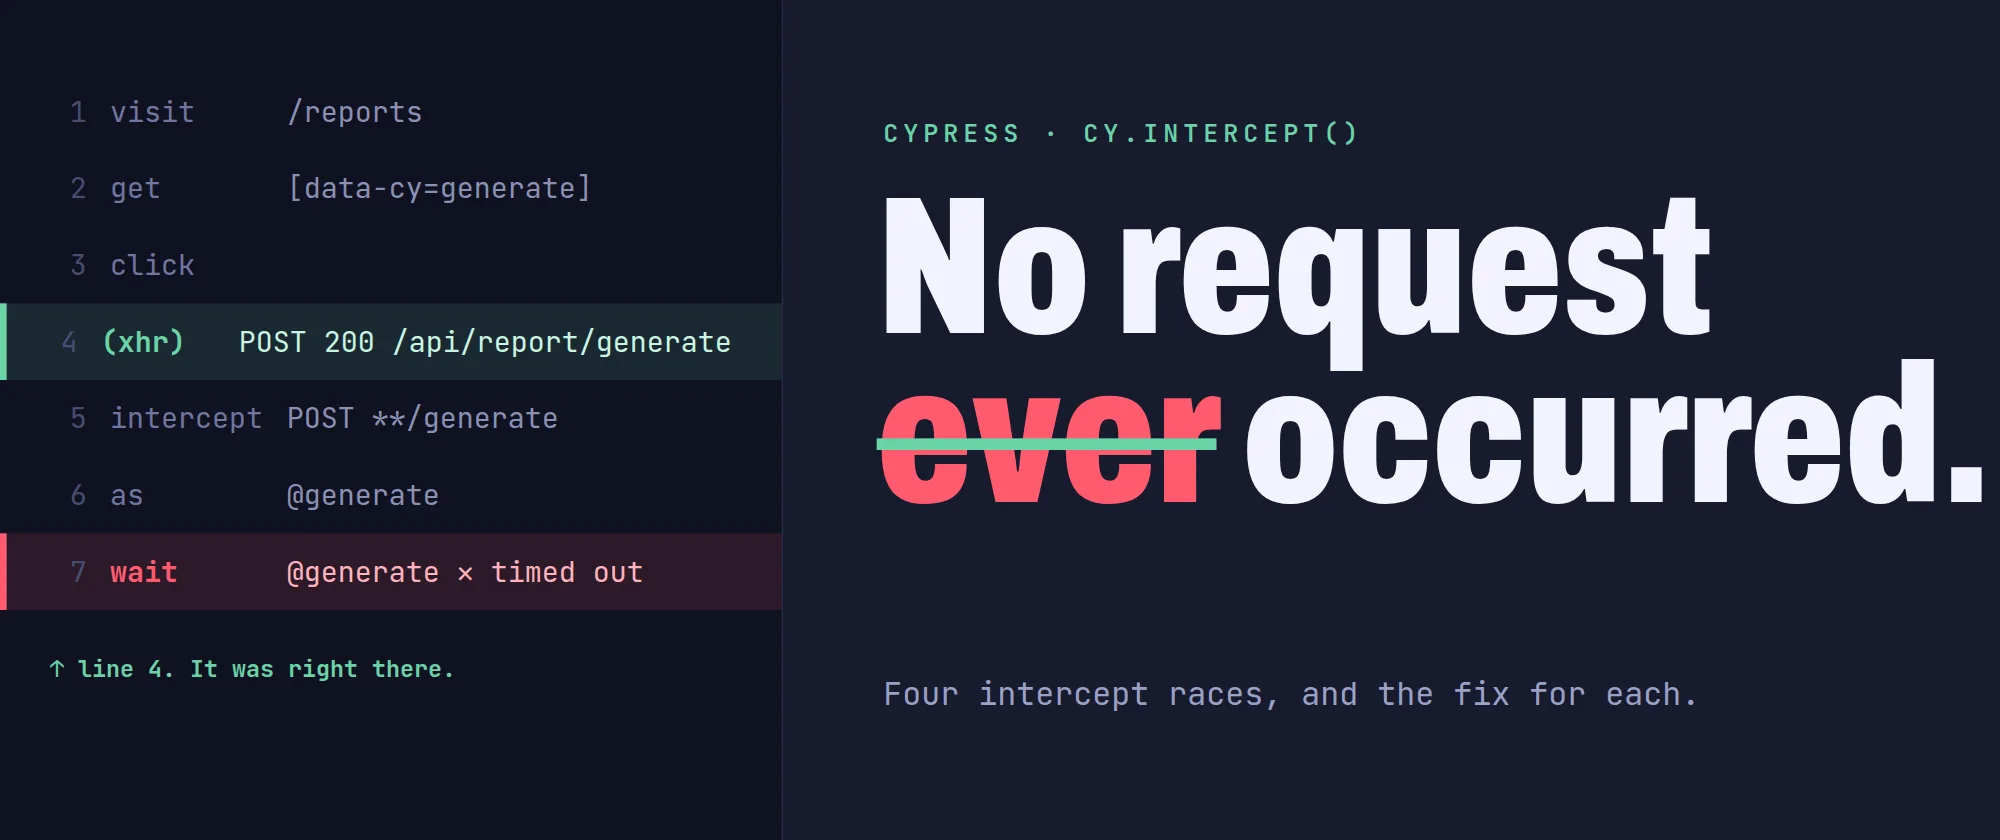
Una vez perdí días con un error de Cypress que me estaba mintiendo. La petición que juraba que nunca había ocurrido estuvo en el command log todo el tiempo, y aun así Cypress seguía imprimiendo esto:
CypressError: Timed out retrying after 30000ms:
`cy.wait()` timed out waiting `30000ms` for the 1st request to the route: `saveReport`.
No request ever occurred.
Es el error más engañoso que produce Cypress, porque se lee como una afirmación objetiva sobre la red, y normalmente no lo es. En mi experiencia tiene cuatro causas distintas, y solo una de ellas significa lo que dice el mensaje. Corrige la equivocada y terminas con el spec que todos hemos abierto al menos una vez: tres esperas anidadas y un cy.wait(2000) encima.
Así que vamos al grano: cuatro causas, un mensaje de error y una forma de distinguirlas en más o menos un minuto.
1. Registraste el alias después del disparador
El clásico, el que todo el mundo conoce. Salvo que se esconde de maravilla dentro de un helper.
export function openReport() {
  cy.get('[data-cy="report-btn"]').click()
  cy.intercept('POST', '**/api/report/generate').as('generate')
  cy.wait('@generate')
}
click() → la petición sale → cy.intercept empieza a escuchar → cy.wait espera algo que quizá ya se fue.
El clic dispara la petición. cy.intercept registra un matcher de ruta para las peticiones que ocurren después de configurarlo. Los comandos de Cypress se encolan, así que el orden es exactamente el escrito: clic, y luego empezar a escuchar. Backend rápido, ninguna petición. Backend lento, petición capturada. Este es el que «solo falla en CI» (cuatro palabras que a todo QA le encanta oír), porque CI suele ser más rápido en el salto de red que tu portátil haciendo túnel hacia un entorno remoto.
No lo vas a detectar leyendo el spec, porque el spec solo dice openReport() y parece inocente. La solución es arquitectónica: un helper que espera una petición debe ser dueño del disparador, no ir detrás de él.
export function withIntercept(
  method: string,
  route: string,
  alias: string,
  trigger: () => void,
) {
  cy.intercept(method, route).as(alias)
  trigger()
  return cy.wait(`@${alias}`)
}

withIntercept('POST', '**/api/report/generate', 'generate', () => {
  cy.get('[data-cy="report-btn"]').click()
})
Recibe el disparador como callback. Ahora la firma impone el orden, y quien la llama no puede equivocarse. Cuando convertí un conjunto de helpers compartidos a esta forma, toda una familia de fallos intermitentes en specs no relacionados desapareció en un solo commit. Así sabes que era una condición de carrera a nivel de helper y no de spec.
2. Un handler local del spec cortó la cadena
Esta es la del principio del post. Fue la que más tiempo me costó, así que la voy a explicar con calma.
Supongamos que tu archivo de soporte configura un intercept amplio que varios helpers esperan:
cy.intercept('POST', '**/api/**').as('apiCalls')Luego, en un spec, quieres inspeccionar una respuesta específica, así que añades:
cy.intercept('POST', '**/api/report/generate', (req) => {
  req.continue((res) => {
    expect(res.statusCode).to.eq(200)
  })
})
Ahora el alias compartido @apiCalls deja de resolverse para esa ruta, y cada helper que lo esperaba falla con No request ever occurred. Incluidos helpers del mismo spec que no tienen nada que ver con informes.
Te estarás preguntando «¿cómo puede un intercept en un spec romper helpers que ni siquiera saben que existe?», básicamente porque Cypress ejecuta los handlers de las rutas coincidentes como una cadena, empezando por el registrado más recientemente:
Tu handler local del spec → se ejecuta primero, llama a req.continue() con un callback → completa la petición ahí mismo
@apiCalls, registrado antes → nunca le llega su turno
req.reply() hace lo mismo. Cualquier handler que asume la responsabilidad de la respuesta completa la petición desde ese handler. Tu intercept local no añadió un observador. Sacó la petición de la ruta compartida.
La solución: quédate como middleware puro. Observa la respuesta mediante el hook de eventos y deja que la cadena siga su camino.
cy.intercept('POST', '**/api/report/generate', (req) => {
  req.on('before:response', (res) => {
    expect(res.statusCode).to.eq(200)
  })
})
Mismo acceso a la respuesta, misma capacidad de mutarla, pero este handler no termina la cadena, así que el alias compartido se sigue disparando. req.on('before:response') es la herramienta que realmente querías casi todas las veces que echaste mano de req.continue. Reserva req.continue y req.reply para cuando de verdad quieras adueñarte de la petición.
Cómo detectarlo: la espera que falla está en un alias amplio o compartido, el fallo apareció justo después de que alguien añadiera un intercept específico, y la petición se ve claramente en el command log (sí, todo el tiempo). Si Cypress te muestra la petición y aun así dice que nunca ocurrió, estás ante un problema de propiedad de la cadena. No de red.
3. El guardado solo se dispara cuando el valor cambió
No es una condición de carrera en absoluto, y ninguna reestructuración de intercepts va a ayudar.
Muchos formularios están programados para omitir la petición de guardado cuando el valor enviado es idéntico al actual. Tablas de entrada de datos, editores inline, campos con autoguardado, flujos de «commit»: todos suelen comparar antes de enviar. Tu test escribe 42 en una celda que ya contiene 42, la aplicación correctamente no hace nada y tu espera agota el tiempo.
La pista es que el test pasa una vez y luego falla para siempre, o pasa en un entorno recién restaurado y falla en uno reutilizado:
Primera ejecución → el valor cambia → se dispara la petición de guardado → verde
Cada ejecución posterior → mismo valor, así que es un no-op → ninguna petición → rojo
Si tu reacción es «entonces la solución es restaurar la base de datos», cuidado (tentador, lo sé). Eso esconde la fragilidad en lugar de eliminarla.
Tres opciones reales, en orden de preferencia:
Haz que la entrada sea relativa al estado actual.
cy.get('[data-cy="qty"]').invoke('val').then((current) => {
  const next = Number(current) + 1
  cy.get('[data-cy="qty"]').clear().type(String(next))
})
Restablece el fixture en un beforeEach, para que el valor inicial sea conocido en lugar de heredado.
Valida el resultado en lugar de la petición. Si lo que te importa es que el total se actualizó, espera al total. Una petición es un detalle de implementación; el total renderizado es el comportamiento. Esperar peticiones es un medio para un fin, y los specs que esperan a la red por cosas que podrían observar en el DOM son más difíciles de mantener sin ganar nada a cambio.
4. Un 204 y un evento que nunca llega
Algunos endpoints acusan recibo y delegan. Haces un POST para iniciar un trabajo, el servidor devuelve 204 No Content, y el resultado real llega más tarde por otro canal (un push por websocket, un polling, una segunda petición) cuando hay un resultado que enviar. En el caso vacío o no-op, nunca se envía nada.
Así que una espera construida así se queda colgada:
cy.intercept('POST', '**/api/procedure/run').as('run')
cy.intercept('POST', '**/api/procedure/result').as('result')
cy.get('[data-cy="run"]').click()
cy.wait('@run')
cy.wait('@result')
@run se resuelve. @result agota el tiempo, porque para esta entrada el servidor no tenía nada que informar y correctamente no envió nada.
Un 204 es un acuse de recibo. No un resultado. Así que nunca esperes un evento que el servidor solo envía a veces. Espera aquello sin lo cual la aplicación no puede terminar: el acuse de recibo que puedes observar y, luego, el estado final visible.
cy.intercept('POST', '**/api/procedure/run').as('run')
cy.get('[data-cy="run"]').click()
cy.wait('@run').its('response.statusCode').should('be.oneOf', [200, 204])
cy.get('[data-cy="run-spinner"]').should('not.exist')
cy.get('[data-cy="status"]').should('contain', 'Completed')
Investiga esta a fondo antes de reescribir selectores. Dos specs que heredé estuvieron etiquetados como problemas de fuente de datos durante meses (¡meses!). Los dos eran esto: una delegación con 204 y una espera escuchando un evento que solo existe en el camino no vacío.
Ya que estás aquí: deja de contar peticiones
Fallo relacionado, misma familia:
cy.wait(['@layout', '@layout', '@layout'])Las esperas con conteo exacto meten a fuego un número de peticiones en tu test. En el momento en que la aplicación agrupa legítimamente dos llamadas en una, o añade una cuarta, el spec falla y no te dice nada útil. También son inestables entre entornos donde el caché es distinto.
Una sola espera más una aserción reintentable sobre el estado final hace el mismo trabajo y sobrevive a los refactors. Donde de verdad necesites «todo el trabajo en curso terminó», envuélvelo en un helper con nombre, para que haya un único lugar que corregir cuando cambie el patrón de peticiones de la aplicación.
Triaje en un minuto
Aquí está el minuto que te prometí:
| Lo que ves | Causa | Solución |
|---|---|---|
| Petición visible en el command log, falla la espera en un alias específico | Alias registrado tras el disparador | El helper es dueño del disparador |
| Petición visible, falla la espera en un alias compartido/amplio | Un handler posterior cortó la cadena | req.on('before:response') |
| Pasa una vez y nunca más | El endpoint solo se dispara si hay cambios | Entrada relativa o reset del fixture |
| La primera espera se resuelve, la segunda agota el tiempo; la respuesta fue 204 | Delegación sin evento de resultado | Esperar al ack más el estado final en la UI |
Ese minuto sale más barato que cualquier cy.wait(2000). Y el resultado es real: hacer que los helpers compartidos sean dueños de su disparador eliminó toda una familia de fallos intermitentes en specs no relacionados en un solo commit.
¡Felices pruebas!