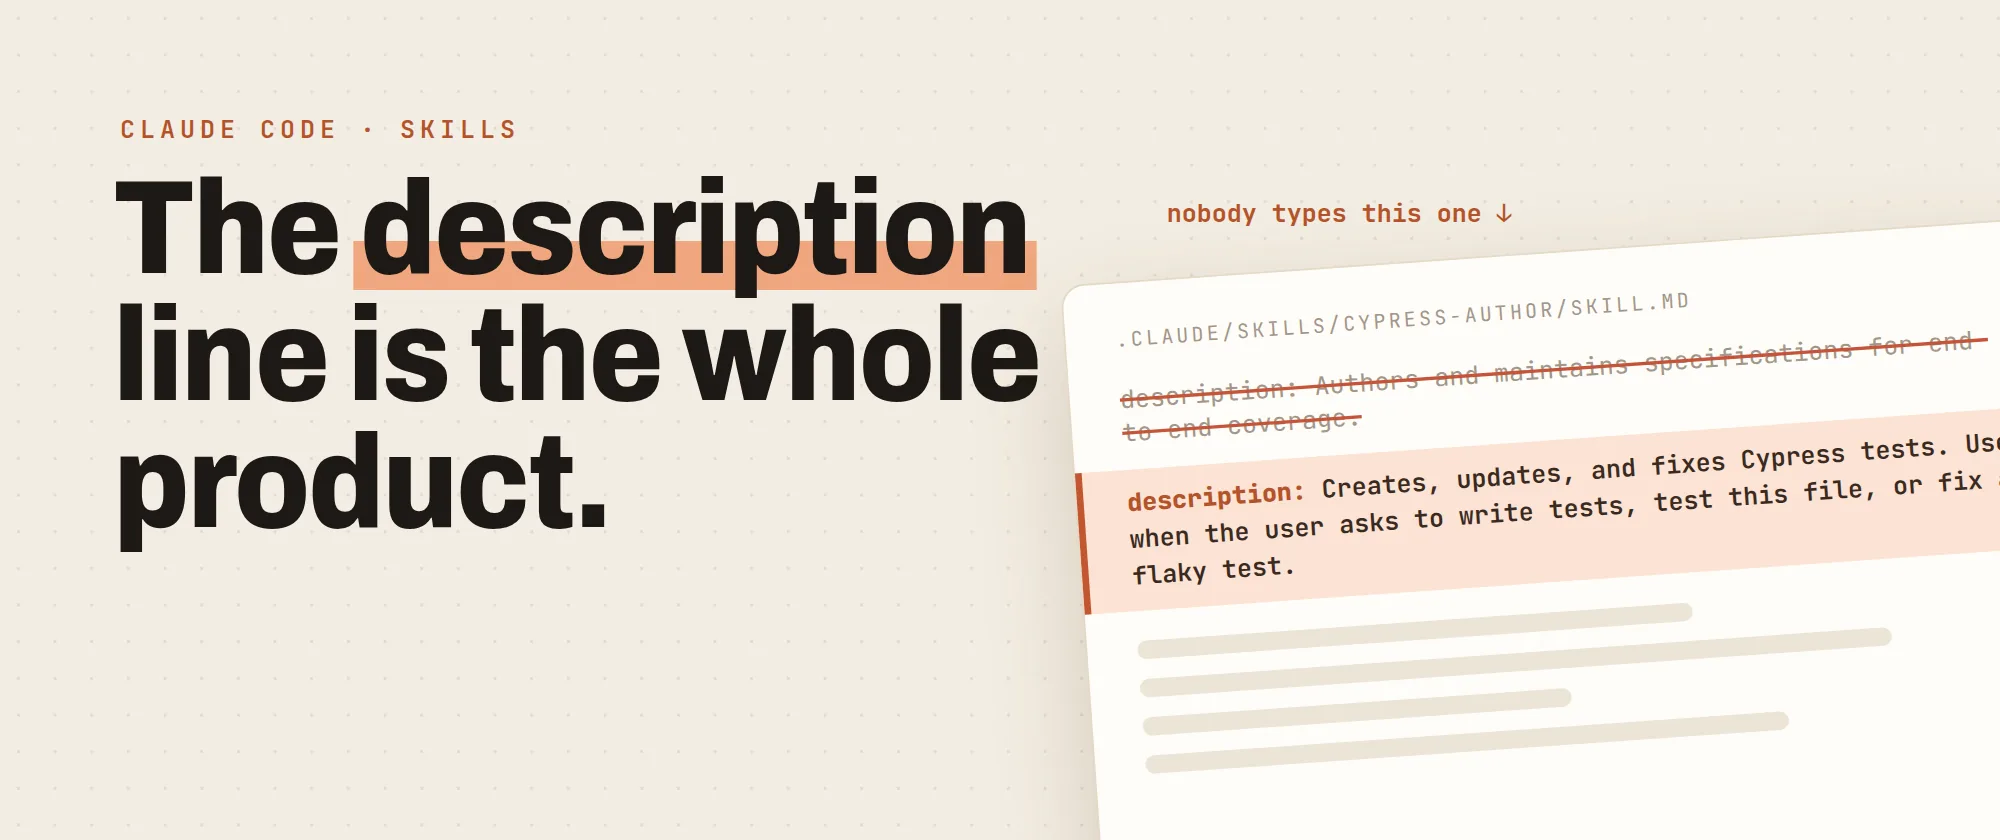
A primeira descrição que escrevi para a minha skill de criação de testes foi "Elabora e mantém especificações para cobertura end-to-end." Certinha, precisa, o tipo de frase que fica linda num design doc. Ninguém digita isso. (Quem escreveu fui eu, então eu deveria saber disso melhor do que ninguém 😅)
E não importava o que eu colocasse embaixo dela: é essa única linha lá em cima que decide se a skill vai ser carregada algum dia.
Já escrevi antes sobre como usei uma skill do Claude Code para concluir a tempo a migração das APIs descontinuadas no Cypress 16. Aquela era uma skill pessoal, mantida fora do repositório. A surpresa veio das skills que eu de fato coloquei no repositório: elas continuaram sendo usadas por pessoas que não eram eu, em tarefas que eu não tinha previsto.
A maioria das skills nunca chega tão longe. Elas são escritas uma vez, disparam nos prompts errados (ou ficam quietas nos certos), e todo mundo volta a colar instruções no chat.
Então, vamos direto ao ponto: o que separou as skills que pegaram das que foram escritas uma vez e abandonadas.
Menos do que você imagina
Uma skill é um diretório com um arquivo markdown. Só isso:
.claude/skills/
  cypress-author/
    SKILL.md
    references/
      selectors.md
E o SKILL.md é frontmatter mais prosa:
---
name: cypress-author
description: Creates, updates, and fixes Cypress tests (E2E and component). Use when the user asks to create tests, add tests, write tests, test this file, new spec, or fix a failing or flaky test. Applies even when the user does not say "Cypress".
---

## Non-negotiables
## Steps
## Verify
Esse é o mecanismo inteiro. O agente vê o nome e a descrição o tempo todo, e só carrega o corpo quando decide que a skill é relevante. Então, adivinha onde o esforço de engenharia deve ir? Isso mesmo, nessa descrição.
A descrição é o produto inteiro
Todo o resto do arquivo é desperdício se a skill nunca disparar. E uma skill que dispara quando não deveria é pior do que uma que nunca dispara, porque agora ela está distorcendo trabalho que não tem nada a ver com ela.
Duas regras fizeram minha precisão de disparo subir bastante.
1. Escreva a descrição com as palavras dos seus usuários, não com as suas
Lembra da minha frase de design doc lá do começo? As pessoas não falam assim. Elas digitam "escreve testes para este arquivo", "adiciona um teste", "essa spec está flaky". Então agora a descrição usa exatamente esse vocabulário. O que você está escrevendo é o alvo de correspondência para um pedido que você ainda não viu, e um resumo caprichado para um leitor humano é a ferramenta errada para esse trabalho.
2. Cubra os pedidos em que a palavra-gatilho não aparece
"cria testes para este componente" não tem nome de framework nenhum. Num repositório com um único framework de testes, ainda assim é, sem sombra de dúvida, trabalho da sua skill. Então diga isso com todas as letras: terminei a descrição com "Applies even when the user does not say Cypress" e o comportamento mudou na hora.
E já que você está nessa, avise também a skill quando ela deve ficar de fora. Se você tem uma skill complementar para revisar testes sem alterar código, diga "prefira aquela quando o usuário só quiser uma explicação". Dá para pensar que a concorrência é o comportamento padrão do modelo. Que nada: ambiguidade entre duas skills suas é uma falha muito mais comum.
Minha única skill espertinha
Minha primeira tentativa juntava criação de testes, revisão e planejamento de reexecução em uma única skill, com ramificações (espertinho, né?). Ela se saiu mal nas três coisas, porque as instruções carregadas para os outros dois trabalhos eram ruído de contexto puxando para direções diferentes.
Então dividi em três skills — author, review, rerun-plan — cada uma com a sua própria descrição bem delimitada. Melhor em todos os aspectos. E elas se combinam naturalmente: o agente escreve os testes com uma → depois aciona a skill de rerun-plan por conta própria, porque aquela descrição bate com o que acabou de acontecer.
Minha regra prática agora é esta: se o corpo da sua skill precisa de um if the user wants X... otherwise... no nível mais alto, você tem duas skills.
Onde o agente fica "prestativo"
É nas restrições negativas que os agentes desviam. As instruções que justificam o próprio espaço são quase todas proibições. O modelo muitas vezes acerta as instruções positivas sozinho; o desvio está no que ele, todo prestativo, faz a mais.
Estas são as linhas que mais mudaram os resultados na minha skill de correção de testes:
- Não rode a suíte. Imprima o comando e pare. (Só o humano sabe se o ambiente está em condições.)
- Não remova uma flag
.only. Ela está ali de propósito. - Não sugira código que foi apagado nesta sessão.
- Não refatore código, comentários ou formatação ao redor.
- Se já existe um helper para isso, use-o. Não escreva um segundo.
Cada uma delas está ali porque eu vi o agente fazer o contrário e precisei corrigi-lo. E esse, no fim das contas, é o verdadeiro loop de escrita de uma skill.
Rode, veja onde desvia, aperte uma linha
Não dá para escrever uma boa skill de primeira. Você escreve uma medíocre (medíocre está ótimo aqui, sério) e deixa que tarefas reais mostrem onde ela erra.
- Escreva a menor versão que poderia funcionar.
- Rode em uma tarefa real, não em uma de brinquedo.
- Anote o primeiro ponto em que a saída divergiu do que você queria.
- Adicione ou aperte exatamente a única instrução que teria evitado isso.
- Repita.
Uma divergência por iteração. Reescreva três instruções de uma vez e você não aprende nada sobre qual delas importou. E skills acumulam linhas de cargo cult rapidinho: texto que está ali porque alguém um dia teve uma execução ruim, e agora ninguém sabe dizer se removê-lo muda alguma coisa.
Para qualquer coisa da qual você vá depender, coloque um número. Rode a skill em dez tarefas representativas e conte quantas precisaram de correção. Leva uma tarde, mostra se a iteração 6 é realmente melhor que a iteração 5, e é a única defesa contra uma skill que parece melhor só porque foi você que escreveu.
"Parece certo" não é pronto
A falha mais comum de uma skill que já funciona é parar no "parece certo". Por quê? Porque o modelo não tem como saber qual é a sua definição de pronto a menos que ela esteja escrita.
Por isso a skill termina com uma seção de verificação, e ela é mecânica de propósito:
## Verify
- Run the type checker on the changed files. It must pass.
- Run the linter on the changed files. It must pass.
- Print the exact headless command for the affected specs.
- List every other spec that touches the helpers you changed.
Essa última linha é a que as pessoas notam. "Quais outros testes eu acabei de colocar em risco" é uma pergunta com resposta concreta que ninguém gosta de levantar na mão. Exatamente o tipo de minúcia mecânica que você quer codificar uma vez e nunca mais pensar no assunto.
De volta à skill de migração
Para constar, já que este post é a continuação daquele. Uma grande varredura de APIs descontinuadas não é difícil. É tediosa de um jeito bem específico: julgamento repetitivo. Milhares de pontos de chamada, cada um exigindo uma decisão que é 90% mecânica e 10% "este aqui é diferente". Três coisas precisavam estar na skill:
1. Uma regra de classificação para os casos que fogem do padrão:
- valor sensível → precisa migrar para outro mecanismo
- valor simples → pode ser reescrito no próprio lugar
Sem uma regra escrita você acaba com uma base de código inconsistente, e isso é pior do que qualquer uma das duas escolhas aplicada de forma uniforme.
2. Um invariante a preservar. A ordem dos comandos importa neste framework, e uma reescrita que muda a ordem fica errada sem dar nenhum sinal. Explicitar o invariante foi o que impediu que isso acontecesse.
3. Uma sequência de verificação a rodar antes de cantar vitória: buscar chamadas antigas que sobreviveram → ativar a configuração que transforma qualquer chamada restante em erro fatal em tempo de execução → deixar o CI ser o juiz. Sem isso, "parece pronto" teria sido a linha de chegada.
Nada disso é específico de IA. É o checklist que você entregaria a um terceirizado fazendo a mesma varredura. E esse é o modelo mental que tornou essas skills úteis para mim: uma skill é documentação de onboarding que executa. Se ela não ajudaria uma pessoa recém-contratada e competente, também não vai ajudar o agente.
Do meu diretório home para o repositório
Última nota prática: mantenha-as independentes de ferramenta. Guardo as skills em .agents/skills/ no repositório e crio symlinks delas no diretório específico da ferramenta:
ln -s ../../.agents/skills/cypress-author .claude/skills/cypress-authorElas são markdown puro, sem sintaxe específica de fornecedor no corpo. Então as mesmas instruções servem para qualquer assistente que um colega prefira, e elas vivem no repositório, onde são revisadas em pull requests como qualquer outra coisa.
Skills que vivem no diretório home de uma pessoa são um truque de produtividade dessa pessoa. Skills no repositório são infraestrutura do time. E foi exatamente aí que as minhas acabaram valendo a pena: as que estão no repositório são as que meu time roda sem mim, em tarefas que eu nunca tive em mente quando as escrevi. Nada mal para uma pasta com um arquivo markdown dentro.
E você? Suas skills vivem no repositório ou no seu diretório home, e qual foi a pior descrição que você já escreveu para uma delas? Me conta nos comentários. A minha já está lá no começo deste post, então você está em boa companhia!