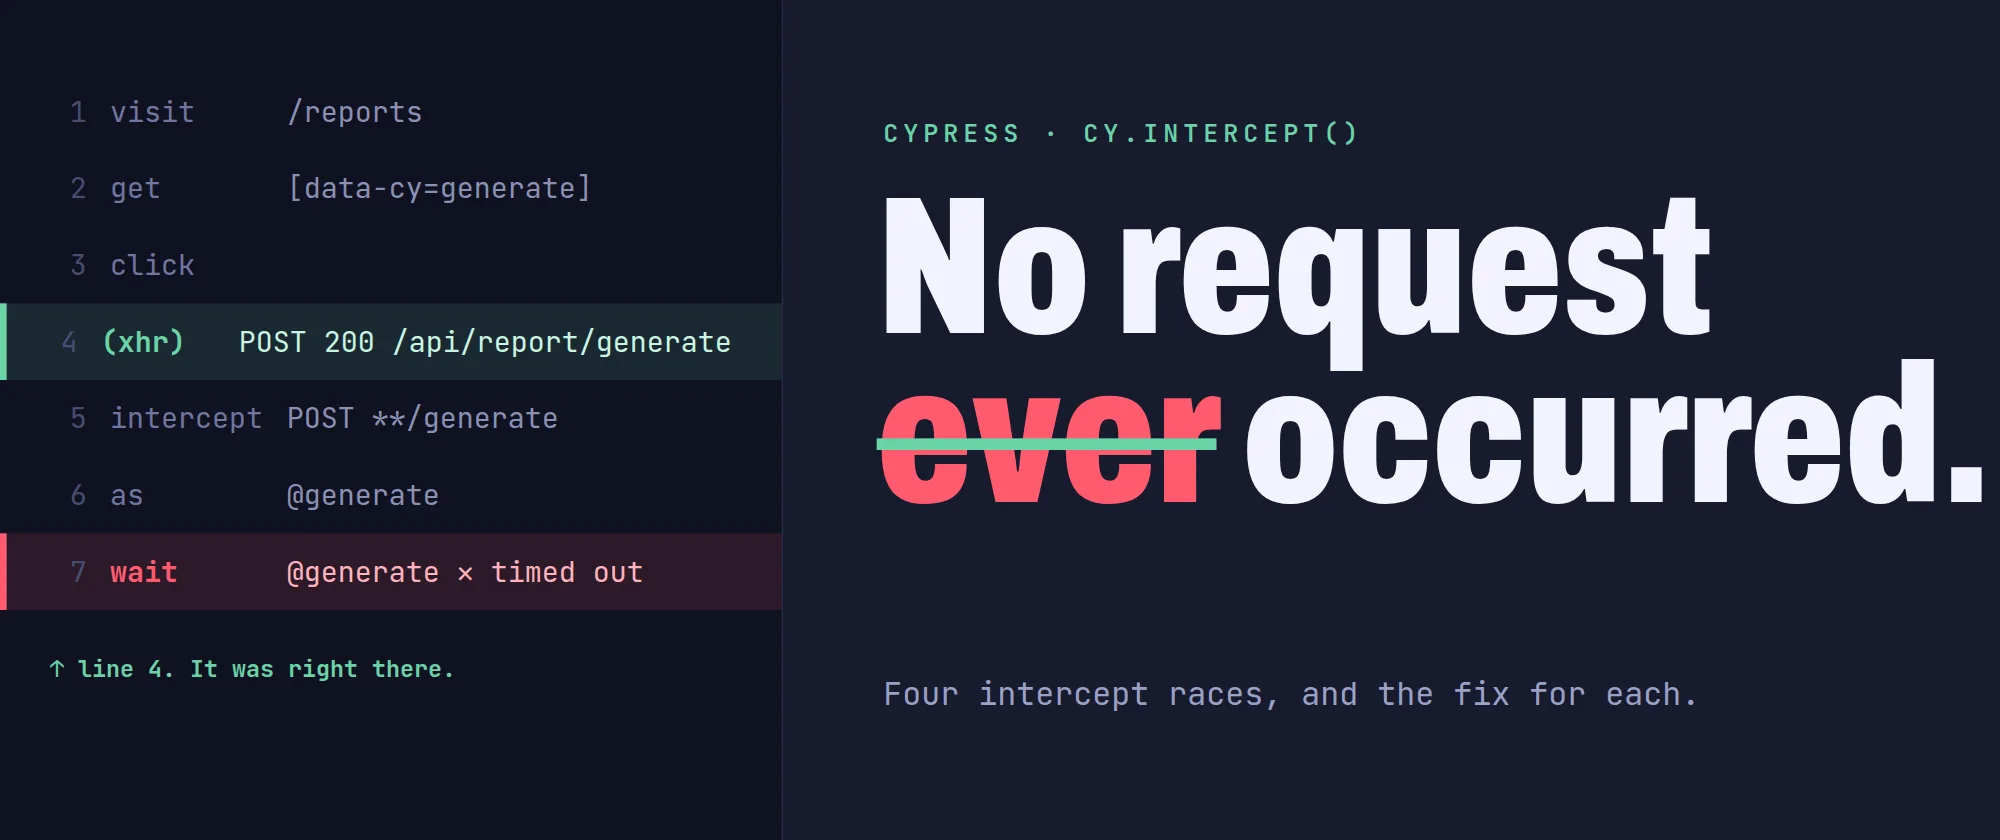
Uma vez perdi dias com um erro do Cypress que estava mentindo para mim. A requisição que ele jurava nunca ter acontecido estava no command log o tempo todo, e mesmo assim o Cypress continuava imprimindo isto:
CypressError: Timed out retrying after 30000ms:
`cy.wait()` timed out waiting `30000ms` for the 1st request to the route: `saveReport`.
No request ever occurred.
Esse é o erro mais enganoso que o Cypress produz, porque parece uma afirmação factual sobre a rede, e quase sempre não é. Na minha experiência, ele tem quatro causas distintas, e só uma delas significa o que a mensagem diz. Corrija a causa errada e você ganha aquela spec que todo mundo já abriu pelo menos uma vez: três waits aninhados e um cy.wait(2000) por cima.
Então, vamos direto ao ponto: quatro causas, uma mensagem de erro e um jeito de diferenciá-las em cerca de um minuto.
1. Você registrou o alias depois do gatilho
O clássico, aquele que todo mundo conhece. Só que ele se esconde perfeitamente dentro de um helper.
export function openReport() {
  cy.get('[data-cy="report-btn"]').click()
  cy.intercept('POST', '**/api/report/generate').as('generate')
  cy.wait('@generate')
}
click() → a requisição sai → cy.intercept começa a escutar → cy.wait espera por algo que talvez já tenha ido embora.
O clique dispara a requisição. O cy.intercept registra um matcher de rota para requisições que acontecem depois que ele é configurado. Os comandos do Cypress entram em fila, então a ordem é exatamente a escrita: clicar e só depois começar a escutar. Backend rápido, nenhuma requisição. Backend lento, requisição capturada. Esse é aquele que "só falha no CI" (quatro palavras que todo QA adora ouvir), porque o CI muitas vezes é mais rápido no salto de rede do que o seu notebook fazendo túnel para um ambiente remoto.
Você não vai perceber isso lendo a spec, porque a spec só diz openReport() e parece inocente. A correção é arquitetural: um helper que aguarda uma requisição deve ser dono do gatilho, e não vir depois dele.
export function withIntercept(
  method: string,
  route: string,
  alias: string,
  trigger: () => void,
) {
  cy.intercept(method, route).as(alias)
  trigger()
  return cy.wait(`@${alias}`)
}

withIntercept('POST', '**/api/report/generate', 'generate', () => {
  cy.get('[data-cy="report-btn"]').click()
})
Receba o gatilho como callback. Agora a assinatura garante a ordem, e quem chama não tem como errar. Quando converti um conjunto de helpers compartilhados para esse formato, uma família inteira de falhas intermitentes em specs não relacionadas desapareceu em um único commit. É assim que você sabe que era uma condição de corrida no nível do helper, e não da spec.
2. Um handler local da spec encerrou a cadeia
Essa é a do começo do post. Foi a que mais me custou tempo, então vou explicar com calma.
Suponha que seu arquivo de suporte configure um intercept amplo que vários helpers aguardam:
cy.intercept('POST', '**/api/**').as('apiCalls')Aí, em uma spec, você quer inspecionar uma resposta específica, então adiciona:
cy.intercept('POST', '**/api/report/generate', (req) => {
  req.continue((res) => {
    expect(res.statusCode).to.eq(200)
  })
})
Agora o alias compartilhado @apiCalls para de resolver para aquela rota, e todo helper que dependia dele falha com No request ever occurred. Inclusive helpers na mesma spec que não têm nada a ver com relatórios.
Você está se perguntando "como um intercept em uma spec consegue quebrar helpers que nunca nem ouviram falar dele?", basicamente porque o Cypress executa os handlers das rotas correspondentes em cadeia, começando pelo registrado mais recentemente:
Seu handler local da spec → roda primeiro, chama req.continue() com um callback → conclui a requisição ali mesmo
@apiCalls, registrado antes → nunca chega a sua vez
req.reply() faz o mesmo. Qualquer handler que assume a responsabilidade pela resposta conclui a requisição a partir dele. Seu intercept local não adicionou um observador. Ele tirou a requisição da rota compartilhada.
A correção: continue sendo middleware puro. Observe a resposta pelo hook de evento e deixe a cadeia seguir adiante.
cy.intercept('POST', '**/api/report/generate', (req) => {
  req.on('before:response', (res) => {
    expect(res.statusCode).to.eq(200)
  })
})
Mesmo acesso à resposta, mesma capacidade de modificá-la, mas esse handler não encerra a cadeia, então o alias compartilhado continua disparando. req.on('before:response') é a ferramenta que você realmente queria quase todas as vezes em que recorreu ao req.continue. Guarde req.continue e req.reply para quando você realmente quiser ser dono da requisição.
Como identificar: o wait que falha está em um alias amplo ou compartilhado, a falha apareceu logo depois que alguém adicionou um intercept mais específico, e a requisição está claramente visível no command log (sim, o tempo todo). Se o Cypress mostra a requisição e ainda assim diz que ela nunca ocorreu, você está diante de um problema de posse da cadeia. Não de rede.
3. O salvamento só dispara quando o valor mudou
Não é condição de corrida nenhuma, e nenhuma reestruturação de intercepts vai ajudar.
Muitos formulários são construídos para pular a requisição de salvamento quando o valor enviado é idêntico ao atual. Grids de entrada de dados, editores inline, campos com salvamento automático, fluxos de "commit": todos costumam comparar antes de enviar. Seu teste digita 42 em uma célula que já contém 42, a aplicação corretamente não faz nada e o seu wait dá timeout.
O sinal é que o teste passa uma vez e depois falha para sempre, ou passa em um ambiente recém-restaurado e falha em um reutilizado:
Primeira execução → o valor muda → a requisição de salvamento dispara → verde
Todas as execuções seguintes → mesmo valor, então é um no-op → nenhuma requisição → vermelho
Se a sua reação a isso é "então a correção é restaurar o banco de dados", cuidado (é tentador, eu sei). Isso esconde a fragilidade em vez de eliminá-la.
Três opções reais, em ordem de preferência:
Torne a entrada relativa ao estado atual.
cy.get('[data-cy="qty"]').invoke('val').then((current) => {
  const next = Number(current) + 1
  cy.get('[data-cy="qty"]').clear().type(String(next))
})
Resete a fixture em um beforeEach, para que o valor inicial seja conhecido em vez de herdado.
Faça asserções sobre o resultado em vez da requisição. Se o que importa é que o total foi atualizado, aguarde o total. Uma requisição é um detalhe de implementação; o total renderizado é o comportamento. Aguardar requisições é um meio para um fim, e specs que esperam pela rede por coisas que poderiam observar no DOM são mais difíceis de manter sem ganho nenhum.
4. Um 204 e um evento que nunca chega
Alguns endpoints só confirmam o recebimento e repassam o trabalho. Você faz um POST para iniciar um job, o servidor retorna 204 No Content, e o resultado de verdade chega depois por outro canal (um push via websocket, um polling, uma segunda requisição) quando há um resultado a enviar. No caso vazio ou no-op, nada nunca é enviado.
Então um wait montado assim trava:
cy.intercept('POST', '**/api/procedure/run').as('run')
cy.intercept('POST', '**/api/procedure/result').as('result')
cy.get('[data-cy="run"]').click()
cy.wait('@run')
cy.wait('@result')
@run resolve. @result dá timeout, porque para essa entrada o servidor não tinha nada a reportar e corretamente não enviou nada.
Um 204 é uma confirmação. Não um resultado. Então nunca aguarde um evento que o servidor só envia às vezes. Aguarde aquilo sem o qual a aplicação não consegue terminar: a confirmação que você consegue observar e, depois, o estado final visível.
cy.intercept('POST', '**/api/procedure/run').as('run')
cy.get('[data-cy="run"]').click()
cy.wait('@run').its('response.statusCode').should('be.oneOf', [200, 204])
cy.get('[data-cy="run-spinner"]').should('not.exist')
cy.get('[data-cy="status"]').should('contain', 'Completed')
Investigue essa a fundo antes de reescrever seletores. Duas specs que eu herdei ficaram marcadas como problema de fonte de dados por meses (meses!). As duas eram isso: um handoff com 204 e um wait escutando um evento que só existe no caminho não vazio.
Já que você está aqui: pare de contar requisições
Falha relacionada, mesma família:
cy.wait(['@layout', '@layout', '@layout'])Waits com contagem exata cravam um número de requisições no seu teste. No momento em que a aplicação legitimamente agrupa duas chamadas em uma, ou adiciona uma quarta, a spec falha e não te diz nada útil. Eles também são instáveis entre ambientes onde o cache se comporta de forma diferente.
Um único wait mais uma asserção com retry no estado final faz o mesmo trabalho e sobrevive a refatorações. Quando você realmente precisa de "todo o trabalho em andamento terminou", encapsule isso em um helper com nome, para que exista um único lugar para corrigir quando o padrão de requisições da aplicação mudar.
Triagem em um minuto
Aqui está o minuto que eu prometi:
| O que você vê | Causa | Correção |
|---|---|---|
| Requisição visível no command log, wait em um alias específico falha | Alias registrado depois do gatilho | O helper é dono do gatilho |
| Requisição visível, wait em um alias compartilhado/amplo falha | Um handler posterior encerrou a cadeia | req.on('before:response') |
| Passa uma vez e nunca mais | O endpoint só dispara quando há mudança | Entrada relativa ou reset da fixture |
| O primeiro wait resolve, o segundo dá timeout; a resposta foi 204 | Handoff sem evento de resultado | Aguardar o ack mais o estado final na UI |
Esse minuto sai mais barato do que qualquer cy.wait(2000). E o resultado é real: fazer os helpers compartilhados serem donos do próprio gatilho eliminou uma família inteira de falhas intermitentes em specs não relacionadas em um único commit.
Bons testes!