Toca confesarse: este septiembre vi cómo el repositorio de esta misma web hacía exactamente lo que he visto hacer a equipos con suites mucho más grandes.
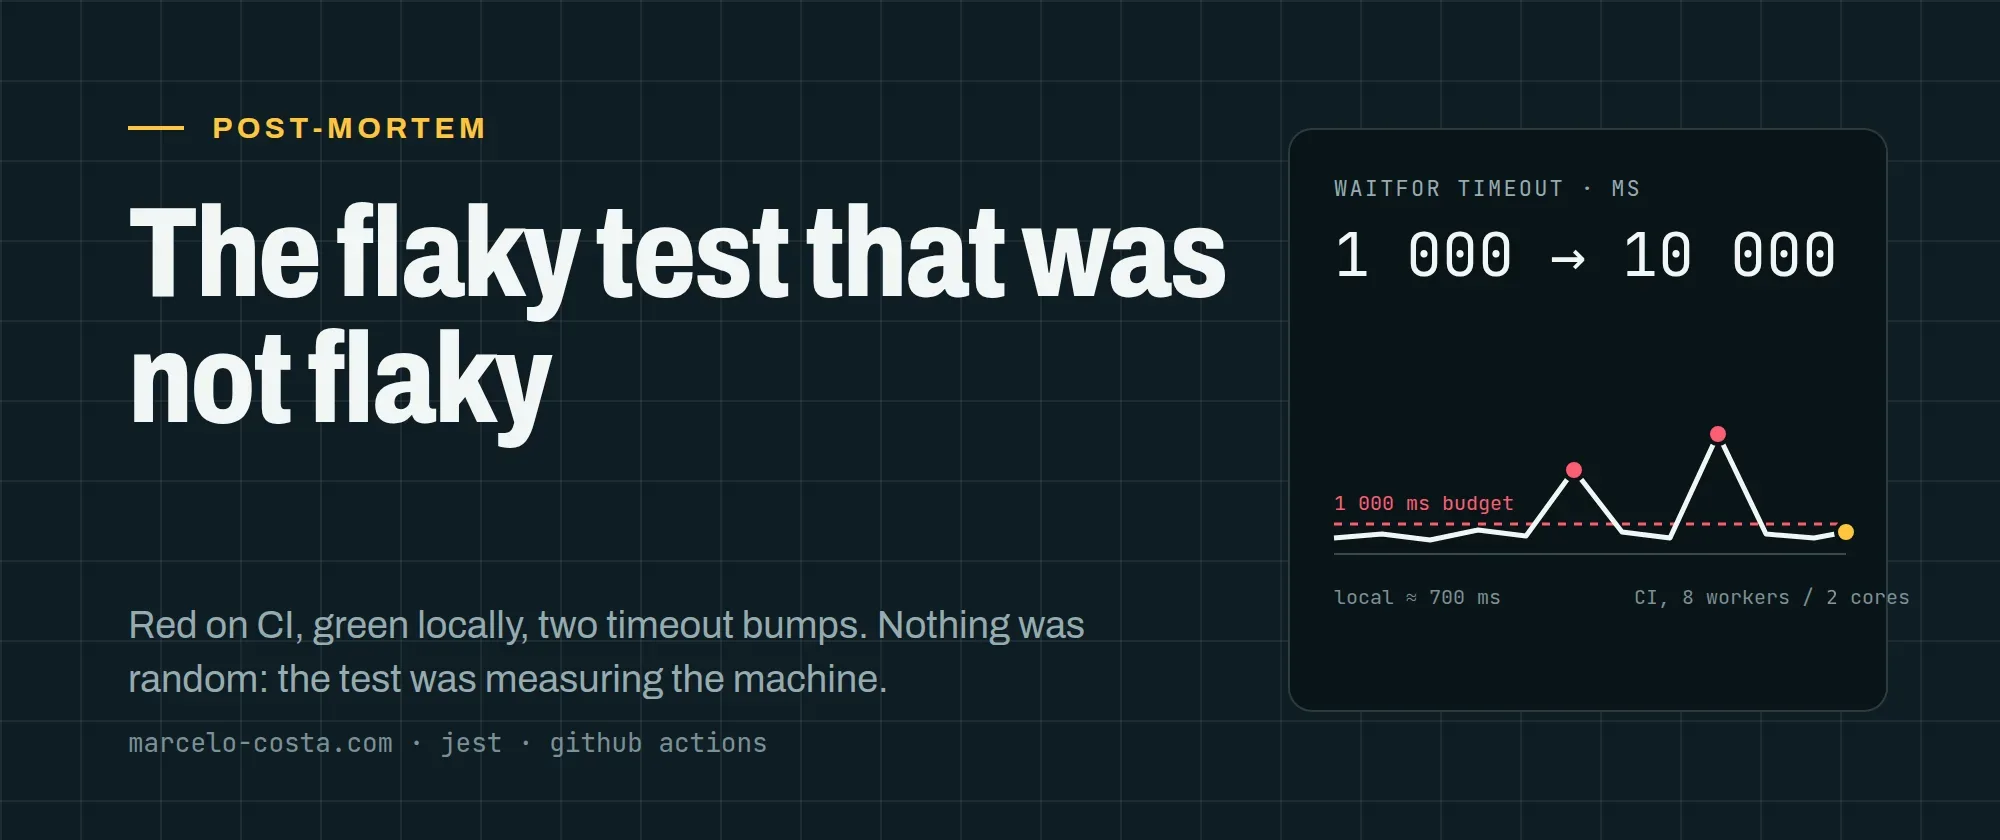
Rojo en CI → verde en local → timeout subido → rojo otra vez → timeout subido otra vez.
(Sí, el propio CI de un Lead QA Engineer. Lo sé.) El test es pequeño y sus resultados son públicos, lo que da para un post-mortem limpio (y del que es difícil esconderse). La página Resultados de Pruebas ahora registra la duración de la suite en cada deploy en parte por culpa suya.
Entonces, fecha a fecha, esto es lo que pasó:
Rojo, verde, rojo otra vez
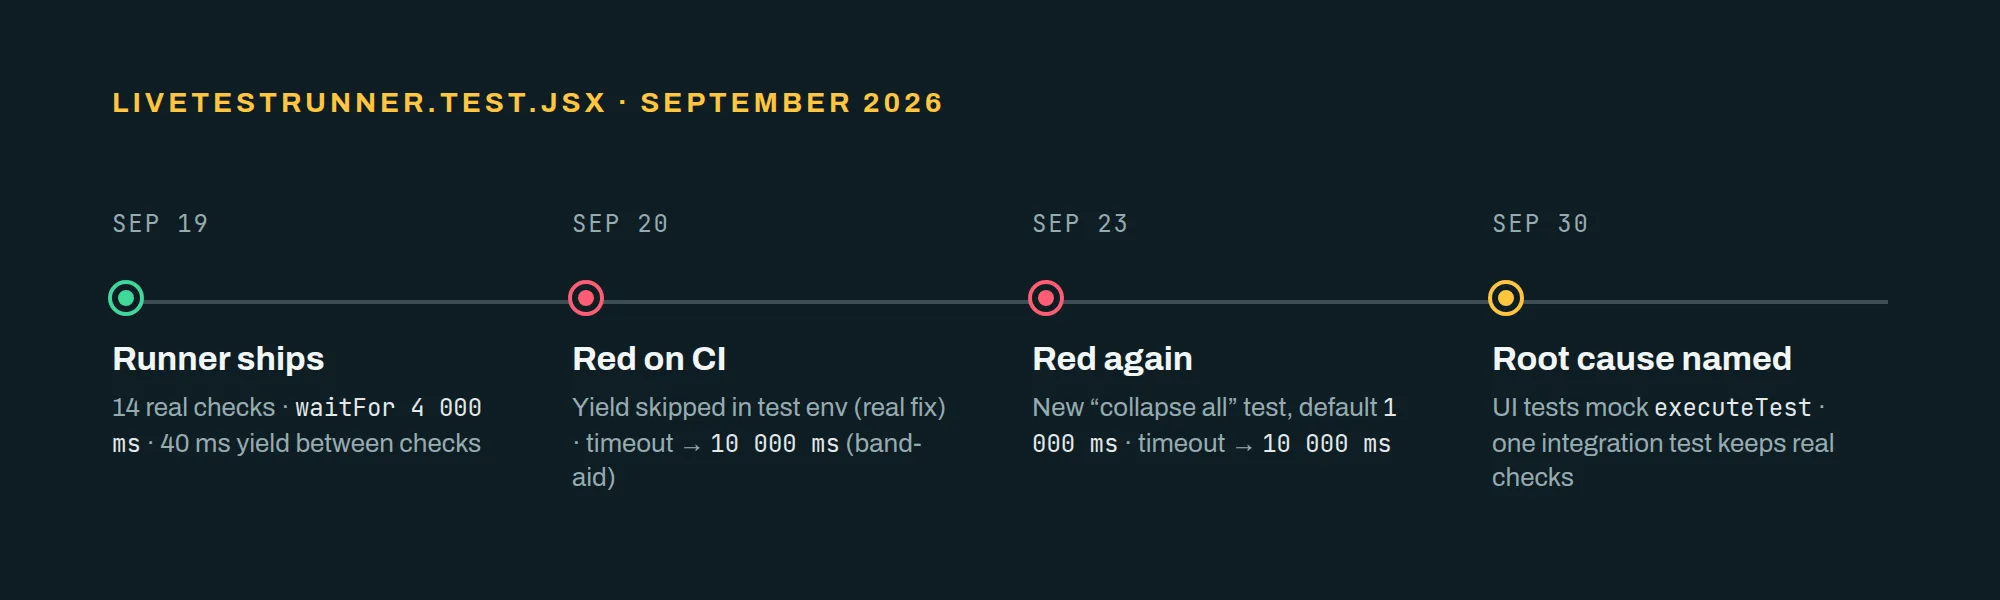
19 de septiembre. Sale el runner de tests en el navegador. Es el widget de la parte superior de la página Resultados de Pruebas: catorce comprobaciones reales contra el DOM en vivo, i18n, red y tiempos. Su test de Jest pulsa "Ejecutar todas las pruebas" y espera al estado completado con un timeout de 4 segundos.
20 de septiembre. El test falla en GitHub Actions. ¿En local? Unos 700 ms. El arreglo: la pausa de 40 ms del runner entre comprobaciones se omite cuando NODE_ENV es test, y el timeout sube a 10 segundos.
23 de septiembre. Una nueva funcionalidad añade "contraer todo" tras una ejecución, con un test nuevo. Espera el botón de reejecutar usando el timeout por defecto de 1 segundo de Testing Library. Rojo en CI esa misma mañana. El arreglo: timeout a 10 segundos. (¿Ya ves un patrón?)
30 de septiembre. Este post y el cambio que se describe abajo.
Flaky es la palabra equivocada
Cada fallo tenía la misma forma. La aserción era correcta. El componente era correcto. El test simplemente no había terminado de hacer lo que estaba esperando cuando se acabó el tiempo.
"Flaky" (inestable) es la palabra a la que todos recurren aquí, y es la equivocada, porque nada era aleatorio. El trabajo era determinista. Solo variaba su duración.
Adónde se fue el tiempo ⏱️
El test esperaba el tiempo de reloj de un trabajo real.
El runner no usa ningún mock. Sus catorce comprobaciones recorren el DOM, solicitan un recurso estático, resuelven una muestra de claves de i18n del idioma activo y esperan un tick de requestAnimationFrame. Dentro de jsdom en un portátil, eso cuesta unos cientos de milisegundos. Dentro de jsdom en un runner de CI compartido, cuesta lo que decida el planificador.
Dos cosas empeoraron la decisión del planificador:
- El runner dormía a propósito. Catorce comprobaciones por una pausa de 40 ms para la UI son 560 ms de cada ejecución gastados sin hacer nada, además de las propias comprobaciones. Eso se arregló el día 20, y fue un arreglo real, no una mitigación.
- Jest tenía demasiados workers. La configuración fija
maxWorkers: 8. El runner alojado tiene 2 vCPU. Ocho workers en dos núcleos → cada suite recibe una fracción de núcleo, justo cuando el test del runner necesita uno entero.
Ninguna de las dos es un bug en la lógica del test. Ambas son el test midiendo la máquina.
Por qué subir el timeout parecía un arreglo
¿Y por qué parecía arreglado? Porque el rojo desapareció. Y porque 10 segundos está tan por encima de la línea base de 700 ms que parecía generoso en vez de ciego.
Pero un timeout es una medición, no un arreglo. Pasar de 1 s a 10 s dice: "esto puede ser diez veces más lento de lo que pensaba y no sé por qué." Nadie escribió esa frase, así que nadie hizo la siguiente pregunta. Tres días después, un segundo test se dio contra el mismo muro.
Dos funciones, un archivo de tests
El componente del runner tiene dos funciones, y los tests las estaban mezclando:
- ¿Ejecuta el runner comprobaciones reales correctamente? Es una cuestión de integración. Un test debería hacerse cargo de ello, ejecutar las comprobaciones reales y poder tomarse su tiempo.
- ¿Reacciona la UI correctamente a una ejecución completada? Contraer todo, expandir todo, botón de reejecutar, indicador de estado. Nada de esto depende de qué comprobaciones corrieron ni de cuánto tardaron.
Los tests de UI ahora mockean executeTest para que resuelva al instante con un resultado aprobado. Corren en milisegundos en local y ya no dependen de lo que hagan las comprobaciones. El único test de integración conserva las comprobaciones reales y conserva su timeout largo, que ahora es honesto: es el único test cuya función es esperar a un trabajo real.
import { executeTest } from '../utils/inBrowserTestRunner';

jest.mock('../utils/inBrowserTestRunner', () => {
  const actual = jest.requireActual('../utils/inBrowserTestRunner');
  return { ...actual, executeTest: jest.fn(actual.executeTest) };
});

const instantPass = async () => ({ status: 'passed', duration: 1, message: null, error: null });

test('offers collapse all after a run, then expand all again', async () => {
  executeTest.mockImplementation(instantPass);
  render(<LiveTestRunner />);
  fireEvent.click(screen.getByRole('button', { name: 'testDashboard.runner.runAll' }));
  await waitFor(() => {
    expect(screen.getByText('testDashboard.runner.rerun')).toBeInTheDocument();
  });
  // ...
});
Básicamente, instantPass convierte cada comprobación en un aprobado al instante.
¿Arreglado, entonces? No del todo. Ese cambio también quitó el timeout de 10 segundos del waitFor de este test, y CI se puso en rojo en ese mismo push. En este test. ¡Con todas las comprobaciones resolviéndose al instante! El detalle: una ejecución sigue siendo catorce pasos secuenciales, cada uno con su salto de temporizador y su re-renderizado, y en un runner bajo contención eso superó el segundo por defecto. Los 10 segundos volvieron diez minutos después.
Así que el test ya no espera a trabajo real, pero hasta que se implemente el primero de los pendientes de abajo, sigue midiendo la máquina.
Qué haría distinto
Sobre todo, elegir mejores palabras antes. "Lento bajo contención de CPU" lleva a algún sitio; "flaky" lleva a un botón de reintentar. Y tratar una subida de timeout como una pregunta: si un test necesita diez veces su duración local, escribe por qué antes de mergear. Si no puedes, no has encontrado la causa.
También separaría el test de integración lento de los tests de comportamiento rápidos desde el primer día (el archivo de tests del runner tenía cuatro tests esperando trabajo real cuando solo dos lo necesitaban), y registraría duraciones. La página Resultados de Pruebas ahora guarda el tiempo de la suite por deploy en su historial; una línea de tendencia habría mostrado el suelo de CI subiendo mucho antes de que un solo test lo cruzara.
Aún pendiente
Dos pendientes se quedaron fuera de este cambio:
- Limitar
maxWorkersal 50% para que CI deje de pelearse consigo mismo. Se quedó fuera a propósito: afecta a todas las suites y merece su propia medición. - Hacer que el test de integración culpe a lo correcto. La comprobación de
requestAnimationFramedel runner falla por encima de 200 ms. Bajo contención, eso es un fallo legítimo del entorno, no del sitio, y el test de integración debería decirlo en su mensaje.
Así quedan las cosas: tests de UI que corren en milisegundos en local, un test de integración cuyo timeout largo ahora es honesto y un waitFor de 10 segundos que por fin puedo explicar. Repositorio pequeño, test pequeño, misma lección que las suites de cuatro horas: el error caro es depurar un test que nunca estuvo mal.
¿Y tú? ¿Cuál es el timeout más grande que has subido antes de saber qué medía? Déjame un comentario, ¡me encantaría saber el número!