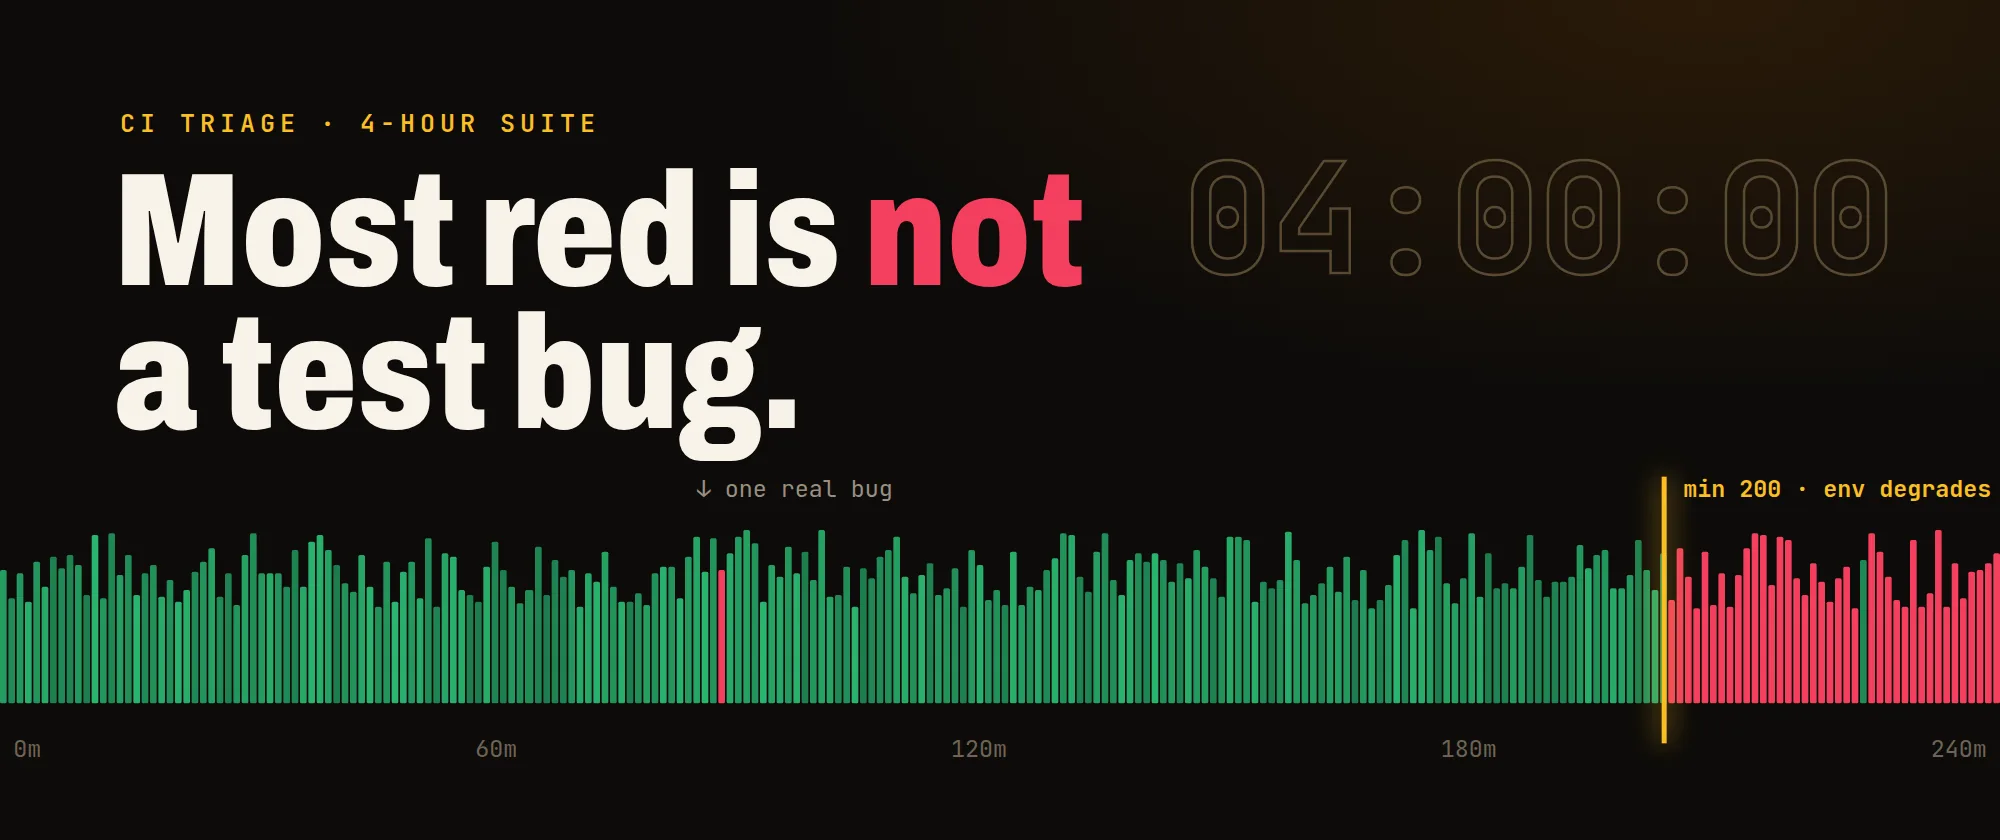
Cuatro horas. Miles de tests. Y la mayor parte del rojo no es un bug del test.
Mantengo una suite de ese tamaño, y el error más caro que puedo cometer ahí es depurar un test que nunca estuvo mal.
Cuando una suite es pequeña, el triaje consiste en leer un stack trace. A este tamaño es un trabajo completamente distinto. Después de suficientes ejecuciones dejas de leer fallos individuales y empiezas a leer la forma del conjunto de fallos, así que el triaje que uso de verdad lo escribí así: como huellas de fallo.
Quince segundos antes de cualquier spec
Abre el informe y responde una pregunta antes de abrir un solo spec: ¿el rojo está correlacionado?
- Fallos repartidos por funcionalidades sin relación entre sí, todos en el mismo selector genérico → entorno.
- Fallos agrupados en una sola área funcional → probablemente un bug real.
- Fallos agrupados en el tiempo (todo a partir del minuto 200) → degradación del entorno.
- Un spec en rojo en cada ejecución mientras todo lo que lo rodea está en verde → un bug real del test o del producto, y el único caso que merece depuración inmediata a nivel de spec.
Esa es toda la pregunta. Lleva quince segundos y encamina correctamente el 90% de las ejecuciones. Así se ve cada forma de cerca.
Seis formas del rojo 🔍
1. Fallo idéntico masivo en un loader o spinner
Fallan treinta specs. Todos en algo como #loading-spinner should not exist, o en una redirección al login, o en un app shell que nunca se renderiza. Los specs no tienen nada en común salvo que están autenticados.
Es el backend caído, y se ve exactamente igual que un selector compartido roto. Esa ambigüedad es la trampa. Alguien "arreglará" el selector, y ahora tendrás dos problemas: un selector malo y un entorno caído.
¿Y cómo los distingues de un vistazo? Abre el cuerpo de la respuesta de la petición que falló, no la captura de pantalla:
- Capa de aplicación caída → un payload de error, una página de error en HTML, un 502 o un cuerpo vacío donde debería haber JSON.
- Selector renombrado de verdad → una respuesta perfectamente sana, y una página renderizada que simplemente no contiene tu elemento.
La captura de pantalla es el artefacto menos informativo del paquete (te enseñará encantada un spinner y nada más). El log de red, el que más. Hasta que el cuerpo de la respuesta diga lo contrario, un fallo idéntico masivo en un selector compartido es una señal del entorno, y nadie edita un selector basándose en una captura de pantalla.
La acción es casi aburrida: reinicia el entorno, vuelve a ejecutar y no cambies nada en el código. Si los mismos treinta specs se ponen en verde, el diff que estabas a punto de escribir iba a empeorar las cosas.
2. Una lane que solo falla al final de una ejecución larga
Aquí es donde la trama se complica, hora a hora. Este es el patrón en el que más me costó confiar: una lane falla de forma consistente, pero solo cuando se ejecuta tarde. Ejecuta esos mismos specs por separado y salen en verde. Siempre.
Eso no es un problema del test. Es el entorno degradándose con las horas: pools de conexiones, presión de memoria, sesiones filtradas, locks que se acumulan, un servidor de licencias que empieza a rechazar a partir de N conexiones. Tus tests son el canario, y estás a punto de pasar un día depurando al canario.
La confirmación es barata, así que exígela antes de que nadie toque el código: vuelve a ejecutar solo ese subconjunto contra un entorno recién levantado. Verde significa degradación. Punto.
El arreglo a menudo sale gratis. Mueve la lane para que se ejecute primero. Mismo tiempo total de reloj, backend recién iniciado, el rojo desaparece.
¿Es hacer trampa? Desde luego lo parece. No lo es. El orden de las lanes es una decisión de planificación que ya estás tomando de forma implícita, y dejar tu trabajo más sensible al entorno para la cuarta hora es una elección sin ninguna ventaja.
Eso sí, una advertencia honesta: reordenar esconde una debilidad real del producto. Regístrala, cuéntale al equipo de backend lo que cuatro horas de carga le hacen a su servicio y guarda la nota. Tienes información que ellos no pueden conseguir fácilmente.
3. Rojo en el primer intento, verde en el reintento, con un 5xx en el log
Un error de servidor no controlado en un endpoint. Intermitente, imposible de reproducir en local. Los reintentos lo tapan, la suite reporta verde y nadie lo mira nunca.
Aquí hago dos cosas. Primero, haz que el fallo sea legible: registra el cuerpo de la respuesta cuando falla, no solo el código de estado. Segundo, haz que la petición se pueda encontrar con grep en los propios logs del servidor. Mete en la petición un valor de correlación que un ingeniero de backend pueda buscar (un token con el epoch en milisegundos o un id de ejecución) e imprímelo cuando falle.
const correlationId = Date.now()
cy.intercept('POST', '**/api/export', (req) => {
  req.body = { ...req.body, correlationId }
}).as('export')

cy.get('[data-cy="export"]').click()

cy.wait('@export').then(({ response }) => {
  if (response && response.statusCode >= 500) {
    cy.task('log', `export failed correlationId=${correlationId} body=${JSON.stringify(response.body)}`)
  }
})
Básicamente, la petición de exportación ahora lleva un token que el backend puede buscar con grep, y cualquier 5xx lo imprime junto con el cuerpo. Ojo con un detalle: haz el log después de cy.wait, no dentro del handler del intercept. Cypress hace fallar el test si un handler encola un comando como cy.task.
Esa es la diferencia entre "la exportación a veces da 500" y "la exportación dio 500 con correlationId 1751022913004". Uno es un ticket que se cierra como no reproducible. El otro se arregla.
4. Un estado vacío que ningún reintento pone en verde
"No rows to show." "No data available." Reintento, reintento, reintento. Todo en rojo, varios minutos perdidos.
Una vista vacía casi siempre significa que una carga de datos falló y el componente se tragó el error convirtiéndolo en su estado vacío. Nada de eso se arregla reintentando, porque la petición no va a volver. Aquí los reintentos son coste puro.
Así que detéctalo y corta por lo sano: recarga una vez, haz la aserción como corresponde y, si sigue vacío, falla rápido con un mensaje que diga data load failed en lugar de element not found. Tu yo del futuro, leyendo el informe a las 8 de la mañana, necesita que el informe distinga "la app está rota" de "el test está mal", y solo tú puedes hacer que lo haga.
5. Estado residual de una ejecución abortada
Alguien cancela una ejecución a medio camino. A partir de ahí, los specs fallan con algo como "this record is already being edited". ¿Editado por quién? Por ti, en una sesión que ya no existe.
El estado del lado del servidor asociado a una conexión que murió no siempre se limpia. El instinto es llamar a la API de desbloqueo en un hook, y a menudo no funciona, porque el lock no está en la base de datos. Vive en el estado en memoria de la capa web, ligado a una conexión que ya no existe. Lo que lo libera es establecer una sesión realmente nueva: borra la sesión en caché y haz un login real en lugar de restaurar una.
Aun así, la lección general es más útil que el arreglo concreto: los hooks de limpieza que llaman a APIs no pueden limpiar estado que vive fuera del alcance de la API. Cuando una limpieza "no hace nada", pregúntate dónde vive realmente el estado antes de hacer la limpieza más agresiva.
6. Un spec, en cada ejecución, con todo lo demás en verde (por fin, uno de verdad)
Ahora sí te has ganado el derecho a depurar el spec. Es el caso minoritario, y el único en el que leer primero el stack trace es lo correcto. Tanto una condición de carrera en un intercept como un ciclo de imports que impide que un archivo de spec cargue viven aquí.
El triaje de cinco minutos empieza en el informe
El problema es este: la mayoría de los equipos no puede hacer nada de lo anterior, porque sus informes no llevan la señal. Cuatro cambios lo arreglan, más o menos por orden de ROI.
Agrupa el resumen de fallos por mensaje de error, no por spec. Este es, con diferencia, el más importante. "Veintiocho fallos, veintiséis de los cuales comparten el mismo mensaje de error" es un diagnóstico con forma de informe. Veintiocho entradas separadas, una por spec, son deberes de lectura.
Timestamps de inicio y fin por spec. Sin ellos no puedes ver la correlación temporal de la huella 2, lo que significa que depurarás esa lane una y otra vez. Durante meses.
El log de red en cada paquete de fallo, y que sea lo primero que abras. Captura de pantalla, vídeo, red. En ese orden de recolección, y en el orden inverso de utilidad.
Un health check del entorno de una línea al inicio de cada lane, que llame a un endpoint de salud y falle de forma ruidosa con el cuerpo de la respuesta. Una lane que muere en diez segundos diciendo "environment unhealthy" vale más que una que muere en cuarenta minutos diciendo "element not found".
Si solo haces uno de ellos, que sea el primero. Agrupa tu informe de fallos por mensaje de error y todo lo anterior se vuelve más fácil: treinta fallos idénticos de spinner se reducen a una sola línea que puedes leer como "entorno", y el único spec que de verdad está roto deja de esconderse entre ellos. Quince segundos para leer la forma, cinco minutos de triaje, y el único spec que abro es el que se lo ha ganado.
¿Y tú? ¿Cuál es la huella de fallo que tu suite no para de dejar a su paso, la que ahora reconoces solo con mirar el informe? Déjame un comentario, ¡me encantaría robarte una séptima!