Hora da confissão: neste setembro, vi o repositório deste próprio site fazer exatamente o que eu já tinha visto times fazerem com suítes bem maiores.
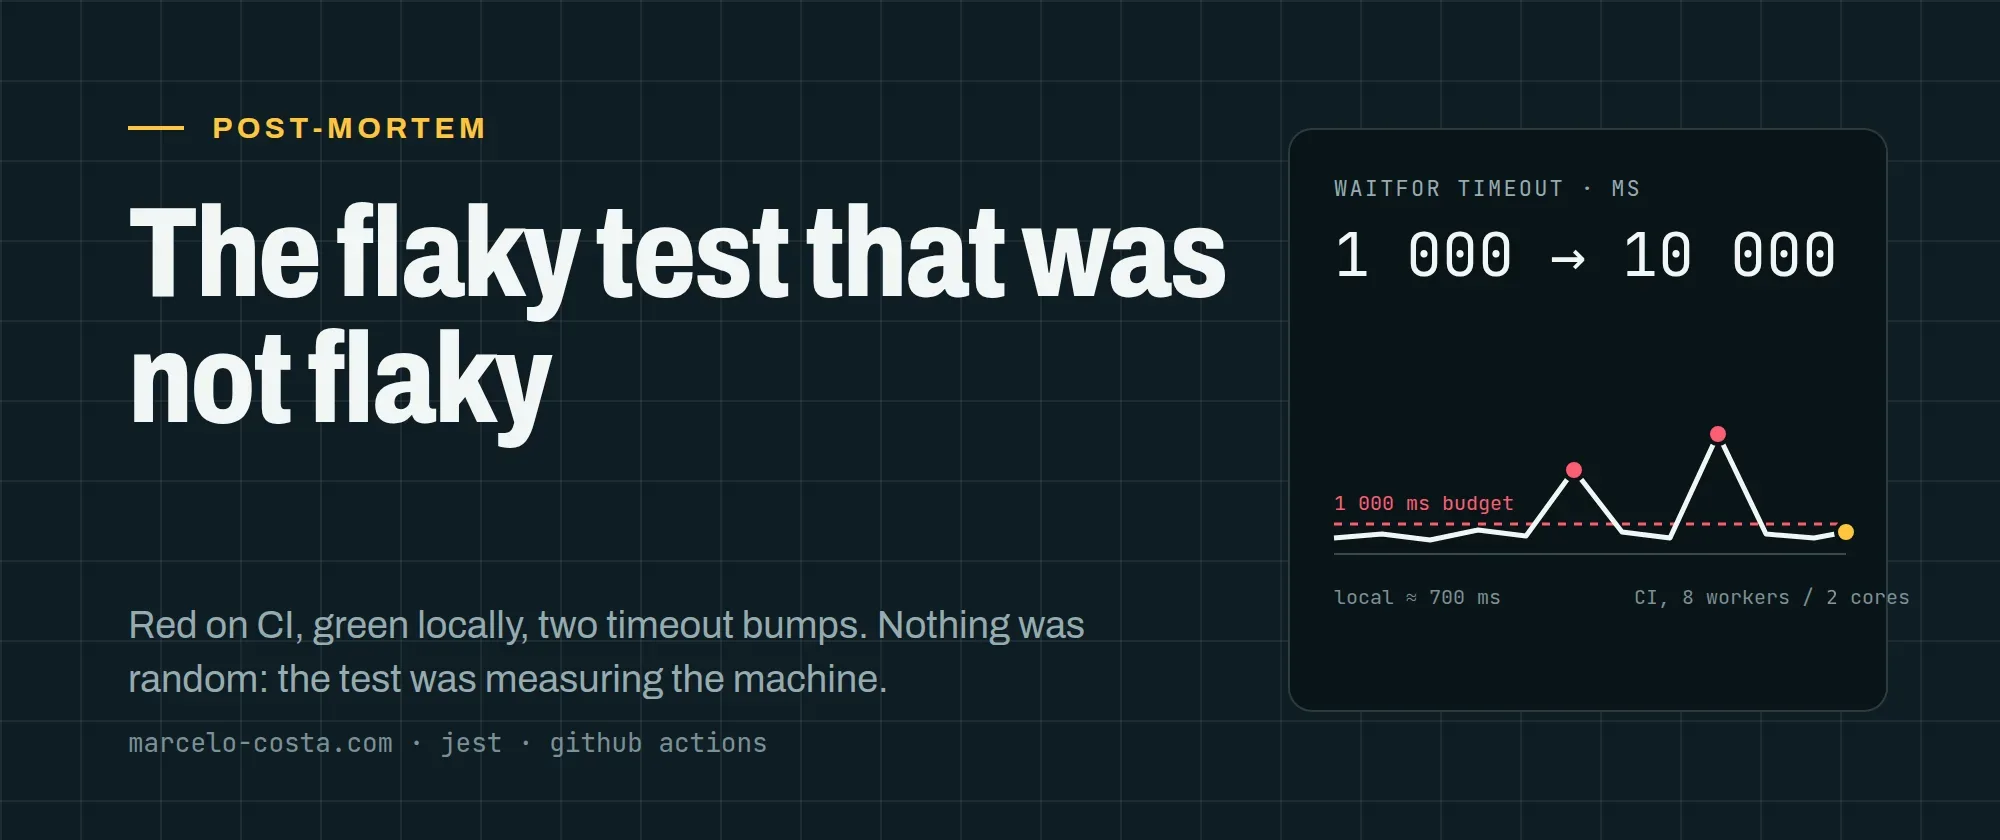
Vermelho no CI → verde local → timeout aumentado → vermelho de novo → timeout aumentado de novo.
(Sim, o próprio CI de um Lead QA Engineer. Eu sei.) O teste é pequeno e seus resultados são públicos, o que rende um post-mortem limpo (e do qual é difícil se esconder). A página Resultados de Testes agora registra a duração da suíte por deploy em parte por causa dele.
Então, data por data, foi assim que aconteceu:
Vermelho, verde, vermelho de novo
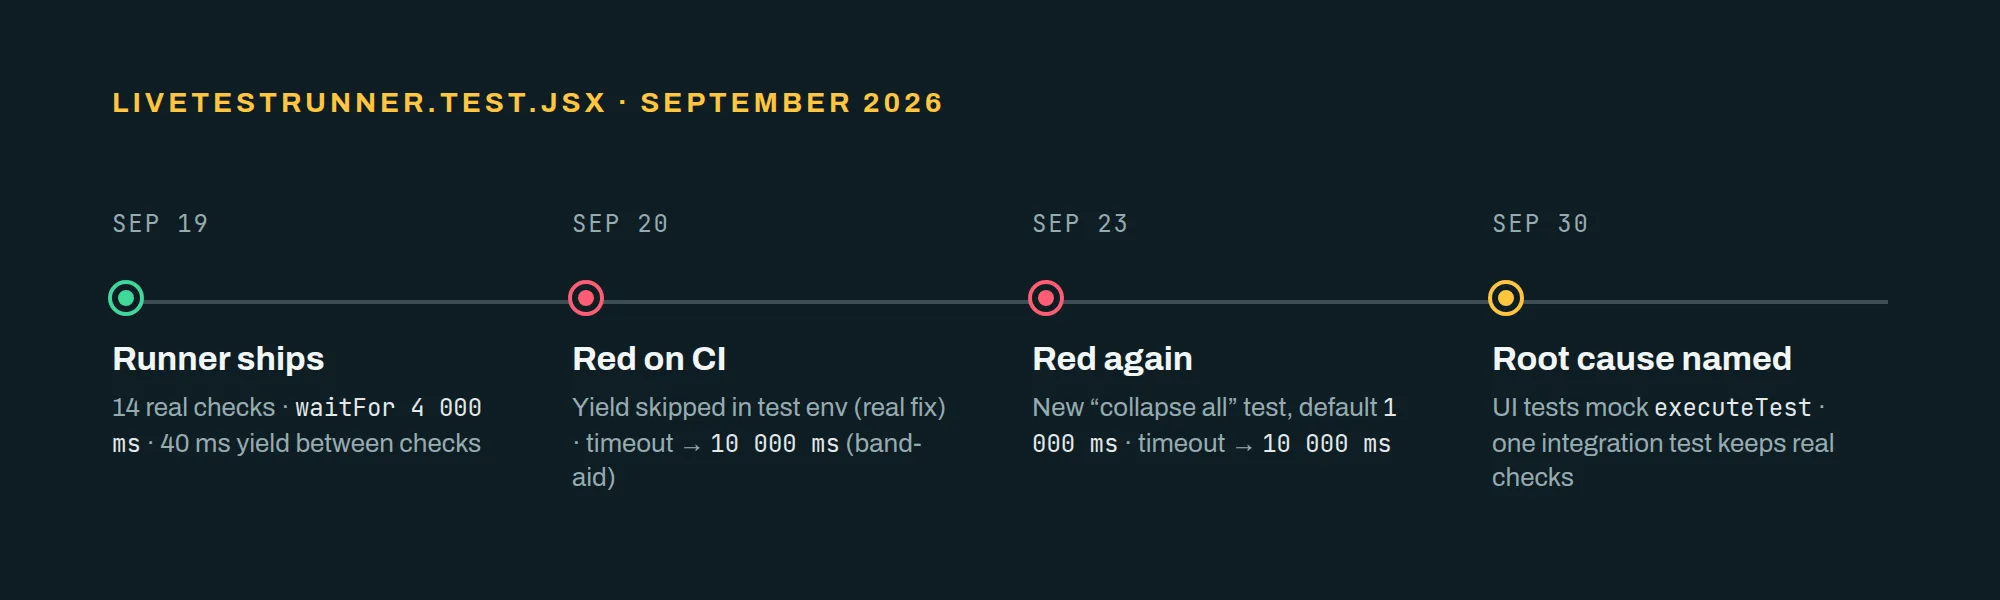
19 de setembro. O runner de testes no navegador entra no ar. É o widget no topo da página Resultados de Testes: quatorze verificações reais contra o DOM ao vivo, i18n, rede e tempos. O teste de Jest dele clica em "Executar todos os testes" e espera o estado concluído com um timeout de 4 segundos.
20 de setembro. O teste falha no GitHub Actions. Localmente? Uns 700 ms. A correção: a pausa de 40 ms do runner entre verificações é pulada quando NODE_ENV é test, e o timeout vai para 10 segundos.
23 de setembro. Uma nova funcionalidade adiciona "recolher tudo" após uma execução, com um teste novo. Ele espera o botão de reexecutar usando o timeout padrão de 1 segundo da Testing Library. Vermelho no CI na mesma manhã. A correção: timeout para 10 segundos. (Já está vendo um padrão?)
30 de setembro. Este post e a mudança descrita abaixo.
Flaky é a palavra errada
Toda falha tinha a mesma cara. A asserção estava correta. O componente estava correto. O teste simplesmente ainda não tinha terminado de fazer o que estava esperando quando o tempo acabou.
"Flaky" (instável) é a palavra que todo mundo usa nessas horas, e é a errada, porque nada era aleatório. O trabalho era determinístico. Só a duração variava.
Para onde foi o tempo ⏱️
O teste esperava pelo tempo de relógio de um trabalho real.
O runner não faz mock de nada. Suas quatorze verificações percorrem o DOM, buscam um recurso estático, resolvem uma amostra de chaves de i18n do idioma ativo e esperam um tick de requestAnimationFrame. Dentro do jsdom em um notebook, isso custa algumas centenas de milissegundos. Dentro do jsdom em um runner de CI compartilhado, custa o que o escalonador decidir.
Duas coisas pioraram a decisão do escalonador:
- O runner dormia de propósito. Quatorze verificações vezes uma pausa de 40 ms para a UI dão 560 ms de cada execução gastos sem fazer nada, além das próprias verificações. Isso foi corrigido no dia 20, e foi uma correção real, não uma mitigação.
- O Jest tinha workers demais. A configuração define
maxWorkers: 8. O runner hospedado tem 2 vCPUs. Oito workers em dois núcleos → cada suíte recebe uma fração de núcleo, exatamente quando o teste do runner precisa de um inteiro.
Nenhuma das duas é um bug na lógica do teste. Ambas são o teste medindo a máquina.
Por que aumentar o timeout pareceu uma correção
Então por que pareceu resolvido? Porque o vermelho sumiu. E porque 10 segundos está tão acima da linha de base de 700 ms que pareceu generoso em vez de cego.
Mas um timeout é uma medição, não uma correção. Ir de 1 s para 10 s diz: "isso pode ser dez vezes mais lento do que eu pensava e eu não sei por quê." Ninguém escreveu essa frase, então ninguém fez a pergunta seguinte. Três dias depois, um segundo teste bateu no mesmo muro.
Duas funções, um arquivo de teste
O componente do runner tem duas funções, e os testes estavam misturando as duas:
- O runner executa verificações reais corretamente? Isso é uma questão de integração. Um teste deveria ser o dono disso, rodar as verificações reais e poder levar o tempo que precisar.
- A UI reage corretamente a uma execução concluída? Recolher tudo, expandir tudo, botão de reexecutar, indicador de status. Nada disso depende de quais verificações rodaram nem de quanto tempo levaram.
Os testes de UI agora fazem mock de executeTest para que ele resolva na hora com um resultado aprovado. Eles rodam em milissegundos localmente e não dependem mais do que as verificações fazem. O único teste de integração mantém as verificações reais e mantém seu timeout longo, que agora é honesto: é o único teste cuja função é esperar por trabalho real.
import { executeTest } from '../utils/inBrowserTestRunner';

jest.mock('../utils/inBrowserTestRunner', () => {
  const actual = jest.requireActual('../utils/inBrowserTestRunner');
  return { ...actual, executeTest: jest.fn(actual.executeTest) };
});

const instantPass = async () => ({ status: 'passed', duration: 1, message: null, error: null });

test('offers collapse all after a run, then expand all again', async () => {
  executeTest.mockImplementation(instantPass);
  render(<LiveTestRunner />);
  fireEvent.click(screen.getByRole('button', { name: 'testDashboard.runner.runAll' }));
  await waitFor(() => {
    expect(screen.getByText('testDashboard.runner.rerun')).toBeInTheDocument();
  });
  // ...
});
Basicamente, instantPass transforma cada verificação em uma aprovação instantânea.
Resolvido, então? Não exatamente. Essa mudança também tirou o timeout de 10 segundos do waitFor deste teste, e o CI ficou vermelho nesse mesmo push. Neste teste. Com todas as verificações resolvendo na hora! A pegadinha: uma execução continua sendo quatorze passos sequenciais, cada um com um salto de timer e uma re-renderização, e em um runner sob contenção isso passou do padrão de 1 segundo. Os 10 segundos voltaram dez minutos depois.
Ou seja, o teste não espera mais por trabalho real, mas, até a primeira pendência abaixo ser implementada, ele continua medindo a máquina.
O que eu faria diferente
Principalmente, escolher palavras melhores mais cedo. "Lento sob contenção de CPU" leva a algum lugar; "flaky" leva a um botão de repetir. E tratar um aumento de timeout como uma pergunta: se um teste precisa de dez vezes a sua duração local, escreva o motivo antes do merge. Se não consegue, você ainda não achou a causa.
Eu também separaria o teste de integração lento dos testes de comportamento rápidos desde o primeiro dia (o arquivo de teste do runner tinha quatro testes esperando por trabalho real quando só dois precisavam) e registraria durações. A página Resultados de Testes agora guarda o tempo da suíte por deploy no histórico; uma linha de tendência teria mostrado o piso do CI subindo muito antes de um único teste cruzá-lo.
Ainda em aberto
Duas pendências ficaram de fora desta mudança:
- Limitar
maxWorkersa 50% para o CI parar de brigar consigo mesmo. Ficou de fora de propósito: afeta todas as suítes e merece sua própria medição. - Fazer o teste de integração culpar a coisa certa. A verificação de
requestAnimationFramedo runner falha acima de 200 ms. Sob contenção, isso é uma falha legítima do ambiente, não do site, e o teste de integração deveria dizer isso na mensagem.
Como as coisas ficaram: testes de UI que rodam em milissegundos localmente, um teste de integração cujo timeout longo agora é honesto e um waitFor de 10 segundos que eu finalmente consigo explicar. Repositório pequeno, teste pequeno, mesma lição das suítes de quatro horas: o erro caro é depurar um teste que nunca esteve errado.
E você? Qual foi o maior timeout que você já aumentou antes de saber o que ele estava medindo? Deixe um comentário, eu adoraria saber o número!