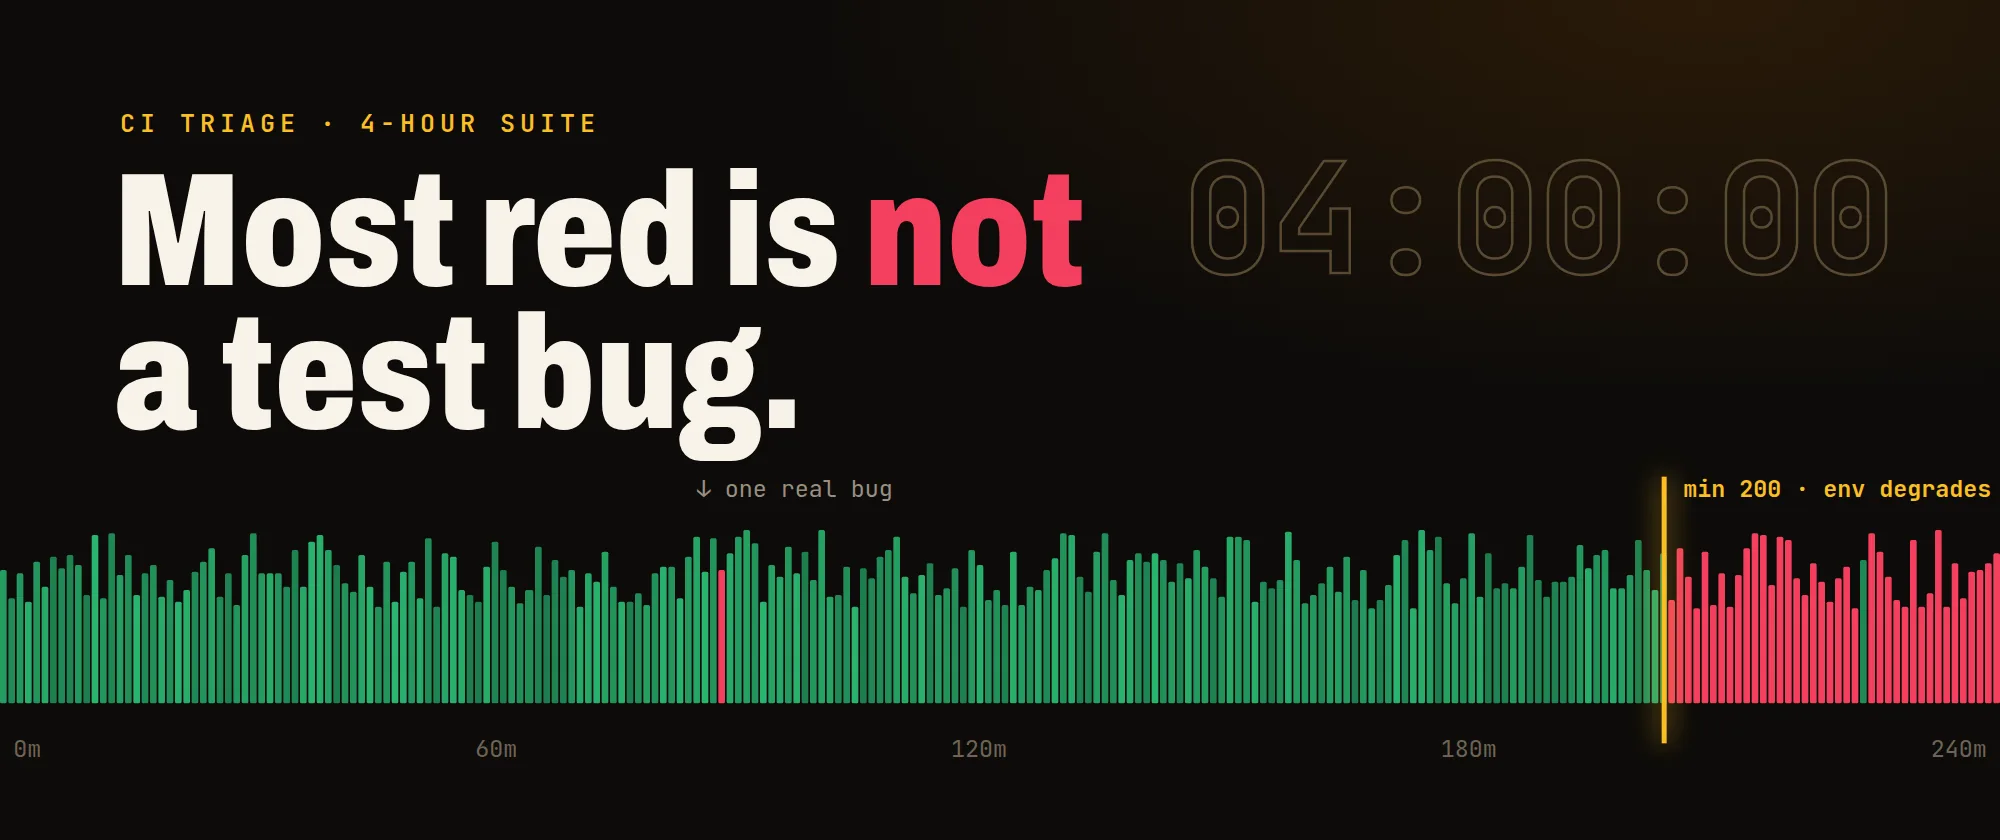
Quatro horas. Milhares de testes. E a maior parte do vermelho não é bug de teste.
Eu mantenho uma suíte desse porte, e o erro mais caro que posso cometer ali é depurar um teste que nunca esteve errado.
Quando uma suíte é pequena, triagem é ler um stack trace. Nesse tamanho, é um trabalho completamente diferente. Depois de um bom número de execuções, você para de ler falhas individuais e começa a ler o formato do conjunto de falhas, então foi assim que escrevi a triagem que eu realmente uso: como assinaturas de falha.
Quinze segundos antes de qualquer spec
Abra o relatório e responda a uma pergunta antes de abrir uma única spec: o vermelho está correlacionado?
- Falhas espalhadas por funcionalidades sem relação entre si, todas no mesmo seletor genérico → ambiente.
- Falhas concentradas em uma única área funcional → provavelmente um bug real.
- Falhas concentradas no tempo (tudo depois do minuto 200) → degradação do ambiente.
- Uma spec vermelha em toda execução enquanto tudo ao redor está verde → um bug real no teste ou no produto, e o único caso que merece depuração imediata no nível da spec.
A pergunta é só essa. Leva quinze segundos e encaminha corretamente 90% das execuções. Veja como cada formato aparece de perto.
Seis formatos de vermelho 🔍
1. Falha idêntica em massa num loader ou spinner
Trinta specs falham. Todas em algo como #loading-spinner should not exist, ou num redirecionamento para o login, ou num app shell que nunca renderiza. As specs não têm nada em comum, exceto o fato de serem autenticadas.
Isso é o backend morto, e parece exatamente um seletor compartilhado quebrado. Essa ambiguidade é a armadilha. Alguém vai "corrigir" o seletor, e agora você tem dois problemas: um seletor ruim e um ambiente morto.
Então, como diferenciar os dois com uma olhada? Abra o corpo da resposta da requisição que falhou, não o screenshot:
- Camada de aplicação morta → um payload de erro, uma página de erro em HTML, um 502 ou um corpo vazio onde deveria haver JSON.
- Seletor que foi de fato renomeado → uma resposta perfeitamente saudável, e uma página renderizada que simplesmente não contém o seu elemento.
O screenshot é o artefato menos informativo do pacote (ele te mostra, todo contente, um spinner e mais nada). O log de rede é o mais informativo. Até que o corpo da resposta diga o contrário, falha idêntica em massa num seletor compartilhado é sinal de ambiente, e ninguém mexe num seletor com base num screenshot.
A ação é quase entediante: reinicie o ambiente, rode de novo e não mude nada no código. Se as mesmas trinta specs ficarem verdes, o diff que você estava prestes a escrever só ia piorar as coisas.
2. Uma lane que só falha no fim de uma execução longa
Agora é que a trama se complica, uma hora de cada vez. Esse é o padrão em que mais demorei a confiar: uma lane falha de forma consistente, mas só quando roda tarde. Rode as mesmas specs isoladamente e elas ficam verdes. Todas as vezes.
Isso não é problema de teste. É o ambiente se degradando ao longo das horas: pools de conexão, pressão de memória, sessões vazadas, locks se acumulando, um servidor de licenças que começa a recusar depois de N conexões. Seus testes são o canário, e você está prestes a passar um dia depurando o canário.
A confirmação é barata, então faça questão dela antes que alguém mexa no código: rode de novo só esse subconjunto contra um ambiente novo. Verde significa degradação. Ponto final.
A correção muitas vezes sai de graça. Mova a lane para rodar primeiro. Mesmo tempo total de relógio, backend recém-iniciado, o vermelho some.
Isso é trapaça? Que parece, parece. Não é. A ordem das lanes é uma decisão de agendamento que você já toma implicitamente, e deixar o trabalho mais sensível ao ambiente para a quarta hora é uma escolha sem nenhuma vantagem.
Mas, sendo honesto, tem uma ressalva: reordenar esconde uma fraqueza real do produto. Registre isso, conte ao time de backend o que quatro horas de carga fazem com o serviço deles e guarde a anotação. Você tem uma informação que eles não conseguem obter com facilidade.
3. Vermelho na primeira tentativa, verde no retry, com um 5xx no log
Um erro de servidor não tratado em um endpoint. Intermitente, impossível de reproduzir localmente. Os retries escondem o problema, a suíte reporta verde e ninguém nunca olha.
Aqui eu faço duas coisas. Primeiro, torne a falha legível: registre no log o corpo da resposta quando falhar, não só o código de status. Segundo, torne a requisição encontrável via grep nos logs do próprio servidor. Coloque na requisição um valor de correlação que um engenheiro de backend possa buscar (um token com o epoch em milissegundos ou um id de execução) e imprima esse valor quando falhar.
const correlationId = Date.now()
cy.intercept('POST', '**/api/export', (req) => {
  req.body = { ...req.body, correlationId }
}).as('export')

cy.get('[data-cy="export"]').click()

cy.wait('@export').then(({ response }) => {
  if (response && response.statusCode >= 500) {
    cy.task('log', `export failed correlationId=${correlationId} body=${JSON.stringify(response.body)}`)
  }
})
Basicamente, a requisição de exportação agora carrega um token que o backend consegue achar com grep, e qualquer 5xx imprime esse token junto com o corpo. Uma pegadinha: faça o log depois do cy.wait, não dentro do handler do intercept. O Cypress falha o teste se um handler enfileira um comando como o cy.task.
Essa é a diferença entre "a exportação às vezes dá 500" e "a exportação deu 500 no correlationId 1751022913004". Um é um ticket que é fechado como não reproduzível. O outro é corrigido.
4. Um estado vazio que nunca fica verde no retry
"No rows to show." "No data available." Retry, retry, retry. Tudo vermelho, vários minutos perdidos.
Uma tela vazia quase sempre significa que uma busca de dados falhou e o componente engoliu o erro dentro do seu estado vazio. Nada disso se resolve com retry, porque a requisição não vai voltar. Aqui, retries são custo puro.
Então detecte isso e interrompa cedo: recarregue uma vez, faça a asserção direito e, se continuar vazio, falhe rápido com uma mensagem que diga data load failed em vez de element not found. O seu eu do futuro, lendo o relatório às 8h da manhã, precisa que ele diferencie "o app está quebrado" de "o teste está errado", e só você pode fazer o relatório dizer isso.
5. Estado deixado para trás por uma execução abortada
Alguém cancela uma execução no meio do caminho. A partir daí, as specs falham com algo como "this record is already being edited". Sendo editado por quem? Por você, numa sessão que já não existe.
Estado no servidor atrelado a uma conexão que morreu nem sempre é limpo. O instinto é chamar a API de unlock num hook, e muitas vezes isso não funciona, porque o lock não está no banco de dados. Ele vive no estado em memória da camada web, preso a uma conexão que já não existe. O que resolve é estabelecer uma sessão realmente nova: limpe a sessão em cache e faça um login de verdade em vez de restaurar uma.
Mas a lição geral é mais útil que a correção específica: hooks de limpeza que chamam APIs não conseguem limpar estado que vive fora do alcance da API. Quando uma limpeza "não faz nada", pergunte onde o estado realmente vive antes de deixar a limpeza mais agressiva.
6. Uma spec, em toda execução, com tudo ao redor verde (finalmente, um de verdade)
Agora você conquistou o direito de depurar a spec. Esse é o caso minoritário, e o único em que ler o stack trace primeiro é o certo. Tanto uma condição de corrida em um intercept quanto um ciclo de imports que impede um arquivo de spec de carregar moram aqui.
A triagem de cinco minutos começa no relatório
Só tem um porém: a maioria dos times não consegue fazer nada disso, porque seus relatórios não carregam o sinal. Quatro mudanças resolvem isso, mais ou menos em ordem de ROI.
Agrupe o resumo de falhas por mensagem de erro, não por spec. Essa é, de longe, a mais importante. "Vinte e oito falhas, vinte e seis delas com a mesma mensagem de erro" é um diagnóstico em forma de relatório. Vinte e oito entradas separadas, uma por spec, são dever de casa.
Timestamps de início e fim por spec. Sem eles você não enxerga a correlação temporal da assinatura 2, o que significa que vai depurar aquela lane repetidamente. Durante meses.
O log de rede em todo pacote de falha, e que ele seja a primeira coisa que você abre. Screenshot, vídeo, rede. Nessa ordem de coleta, e na ordem inversa de utilidade.
Um health check do ambiente, de uma linha, no início de cada lane, chamando um endpoint de saúde e falhando de forma ruidosa com o corpo da resposta. Uma lane que morre em dez segundos dizendo "environment unhealthy" vale mais do que uma que morre em quarenta minutos dizendo "element not found".
Se for fazer só uma dessas, que seja a primeira. Agrupe seu relatório de falhas por mensagem de erro e tudo o que está acima fica mais fácil: trinta falhas idênticas de spinner viram uma única linha que você lê como "ambiente", e a única spec que está realmente quebrada para de se esconder no meio delas. Quinze segundos para ler o formato, cinco minutos de triagem, e a única spec que eu abro é a que fez por merecer.
E você? Qual é a assinatura de falha que a sua suíte vive deixando para trás, aquela que você já reconhece só pelo relatório? Deixe um comentário, eu adoraria roubar uma sétima.